 第 1 课
什么是人工智能?从机器会做什么开始理解 AI
AI 不是会思考的魔法,而是一类让机器完成感知、判断、生成和行动任务的方法与系统。
本阶段学习目标
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
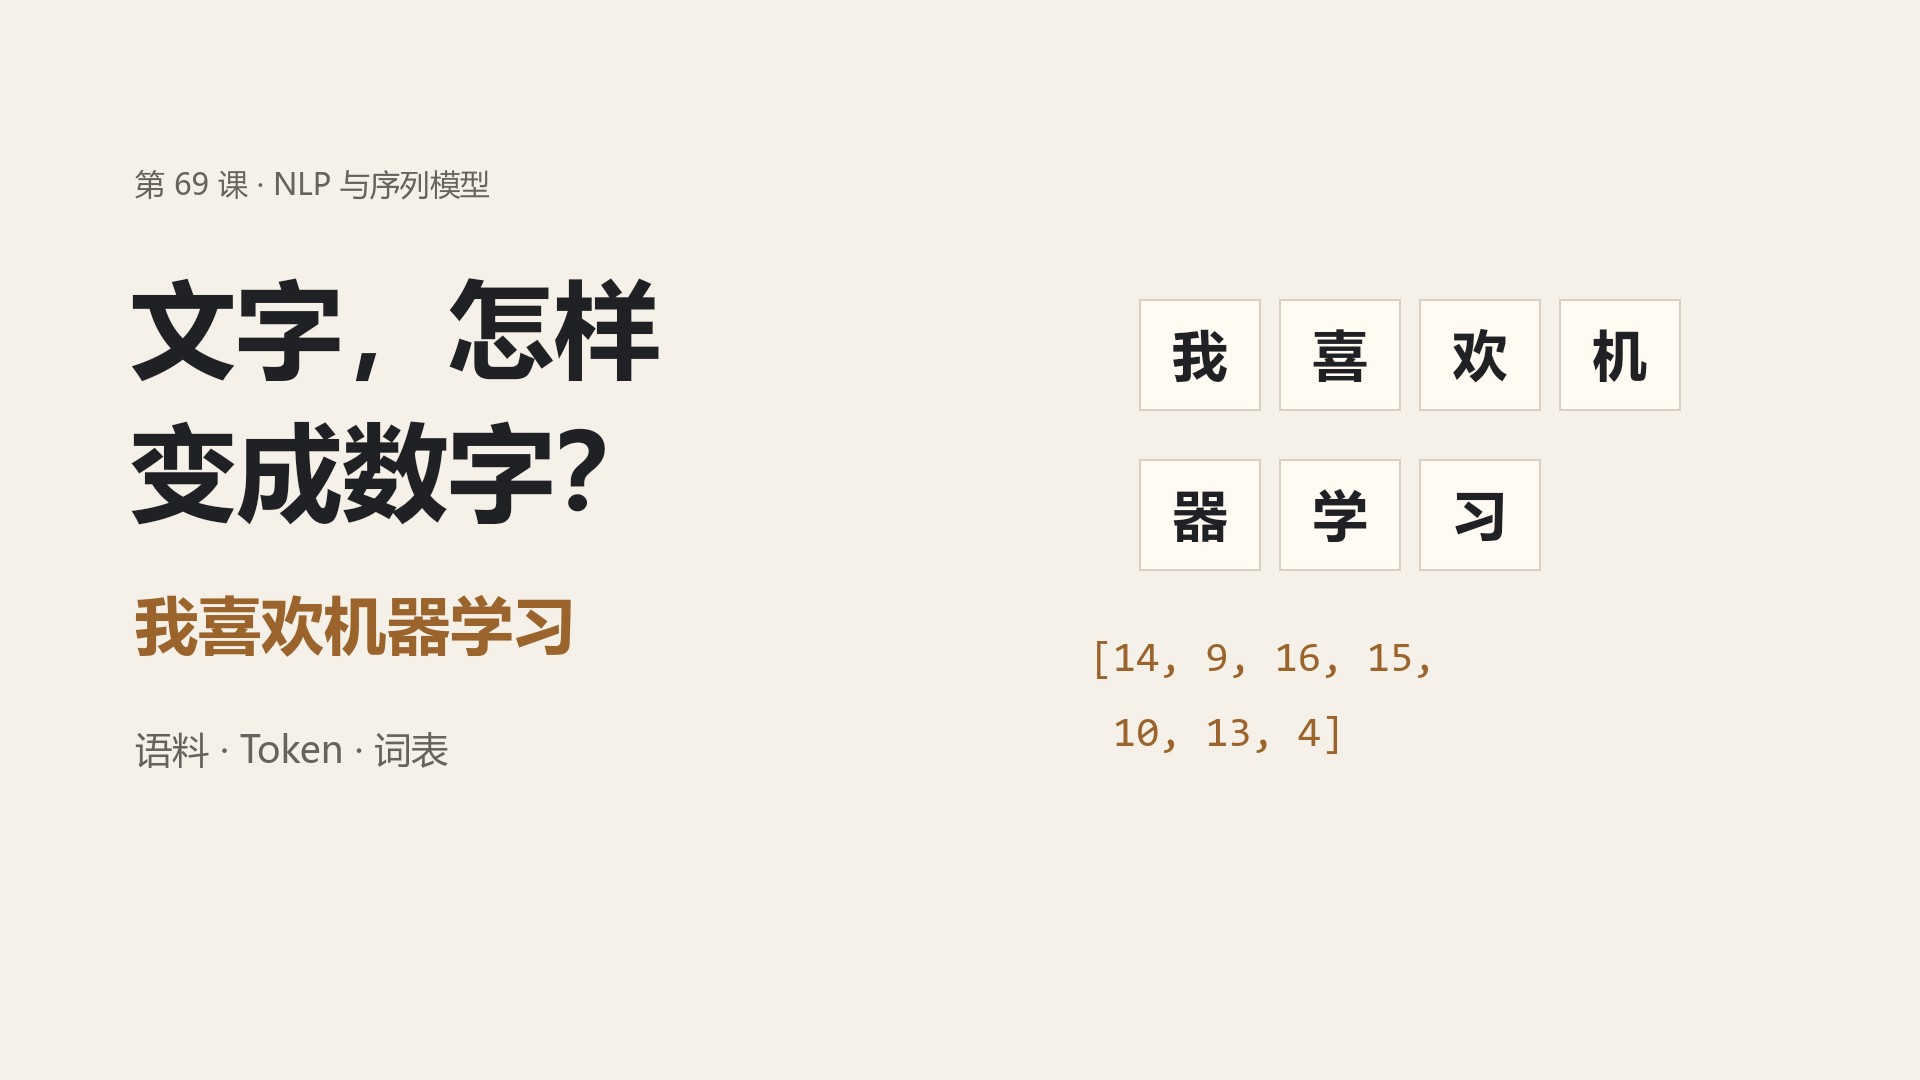 第 69 课最新视频文本怎样变成编号:语料、Token 和词表
没有找到匹配内容。试试更短的关键词,或清除筛选查看全部。
20 个视频,按学习路线顺序排列。
第 1 课AI 不是会思考的魔法,而是一类让机器完成感知、判断、生成和行动任务的方法与系统。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 2 课
用一张由大到小的知识地图,讲清 AI、ML、DL 和生成式 AI 之间的包含与交叉关系。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 3 课
监督学习用带答案的数据学习预测,无监督学习则从没有答案的数据中寻找结构和规律。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 4 课
分类预测离散类别,回归预测连续数值。任务类型会直接决定输出层、损失函数和评价指标。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 5 课
样本是一条完整记录,特征是提供给模型的信息,标签是监督学习希望模型预测的答案。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 6 课
训练集用于学习参数,验证集用于选择方案,测试集只在最后评估一次模型的真实泛化能力。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 7 课
从混淆矩阵出发理解四个分类指标,并根据漏判和误判的实际代价选择评价标准。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 8 课
欠拟合是规律没学会,过拟合是只记住训练数据,数据泄漏则让模型提前看到了不该知道的信息。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 9 课
不从公式开始,而是从“机器怎样学会判断”这件事讲起,把神经网络、神经元、参数、训练和预测串成一条清楚的线。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 10 课
激活函数让神经网络拥有非线性表达能力。没有它,再多层网络也可能只是一个更复杂的线性模型。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 11 课
损失函数像训练过程里的成绩单,告诉模型预测结果和真实答案之间差了多少。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 12 课
梯度下降可以理解成沿着损失函数的坡度往低处走,目标是找到让模型错误更小的参数。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 13 课
CrossEntropyLoss 常用于分类任务,它关注的不只是模型有没有猜对,还关注模型对正确类别有多自信。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 14 课
用“预测、算错、追责、更新”串起一次神经网络训练,并用最小 PyTorch 代码看清 forward、backward 和 step 的分工。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 15 课
Tensor 可以理解成更通用的数组,它承载数据、参数和梯度,是 PyTorch 训练流程的基础。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 16 课
Linear 层本质上是一次线性变换,它把输入特征通过权重矩阵和偏置映射到新的输出空间。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 17 课
DataLoader 负责把数据按批次送进模型,并处理 shuffle、batch size 和多进程加载等训练细节。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 18 课
从准备数据、定义模型、选择损失函数和优化器,到训练循环和验证评估,把 PyTorch 训练主线串起来。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 19 课
一次从短信分类项目出发的复盘:从需求、流程到问题定位,再到后续可以继续优化的方向。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
 第 20 课
从 jieba 分词、TF-IDF 和随机森林开始,到 Flask 接口和 Streamlit 页面,这是一条更完整的中文文本分类落地链路。
AI 入门与 PyTorch 基础(1~20):能说清 AI、机器学习、深度学习、PyTorch 训练流程和一个中文文本分类项目的大致链路。
14 个视频,按学习路线顺序排列。
 第 21 课
一个机器学习项目不是从训练模型开始,而是从定义问题、整理数据、训练评估到上线预测的一整条链路。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 22 课
数据清洗不是把数据改漂亮,而是识别缺失、重复、异常和格式问题,让模型拿到可靠的输入。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 23 课
用一个小型表格案例串起读取数据、检查缺失、去重、处理异常值、编码类别特征和导出干净数据的流程。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 24 课
特征工程不是随便增加几列,而是把原始业务数据整理成模型能稳定学习的信号。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 25 课
Label Encoding 和 One-Hot Encoding 都能把类别变成数字,但它们表达的含义完全不同。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 26 课
标准化和归一化都在处理数值尺度问题,但一个看均值方差,一个看最大最小值。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 27 课
从房价预测出发,理解线性回归的输入、输出、误差和第一个 scikit-learn 实现。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 28 课
用同一组测试数据理解四个常用回归指标,并根据业务代价选择正确的评价方式。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 29 课
理解线性分数、Sigmoid、概率和阈值,跑通第一个二分类逻辑回归示例。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 30 课
理解 K 近邻算法的核心思想、距离度量、K 值选择、特征缩放和 sklearn 训练流程。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 31 课
从分支节点、叶节点、基尼系数、信息增益和 max_depth 入手,理解决策树分类模型。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 32 课
理解随机森林的 Bagging 思想、有放回抽样、随机特征选择、投票机制和常用参数。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 33 课
从多个模型共同决策的直觉出发,理解 Bagging、Boosting、随机森林和梯度提升模型的基本区别。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
 第 34 课
理解训练集、验证集、测试集、交叉验证、平均分和波动,避免用一次随机划分误判模型能力。
传统机器学习基础(21~34):拿到一份结构化表格数据,独立完成清洗、特征工程、建模、评估、模型选择和保存,并用规范流程比较多个算法。
8 个视频,按学习路线顺序排列。
 第 35 课
进入中文文本分类前,先理解文本文件编码、乱码、空白符、标点、大小写和基础清洗规则。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 36 课
理解中文分词为什么重要,停用词应该怎么用,以及在文本分类项目里如何把句子切成可建模的词。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 37 课
从词袋模型开始理解文本向量化,学习 CountVectorizer 如何把分词后的中文文本变成可训练的特征矩阵。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 38 课
从词频和逆文档频率出发,理解 TF-IDF 为什么适合文本分类,以及如何在 sklearn 中使用 TfidfVectorizer。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 39 课
用 TF-IDF 和 LogisticRegression 跑通一个中文文本分类基线模型,理解从分词、划分数据到训练预测的完整流程。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 40 课
学会用 classification_report、confusion_matrix 和错分样本分析文本分类模型,不只看准确率。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 41 课
学会保存完整 Pipeline、标签信息和项目元数据,让文本分类模型不只停留在 notebook 里。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
 第 42 课
把已经训练好的文本分类 Pipeline 接到 Streamlit 页面里,完成输入文本、预测类别和查看置信度的交互演示。
文本分类项目(35~42):从一份原始中文文本出发,独立完成清洗、分词、向量化、训练、评估、保存和演示页面,并能解释每个环节为什么这么做。
16 个视频,按学习路线顺序排列。
 第 43 课
补齐 PyTorch 实际训练中最常用的 Tensor 操作:数据类型、设备迁移、索引、切片和布尔筛选。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 44 课
从一个最小例子理解 PyTorch 如何记录计算过程、自动求梯度,以及为什么训练前要清空梯度。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 45 课
你写了 optimizer.zero_grad() 却不知道为什么要写。这一篇把 PyTorch 的动态计算图、叶子节点和梯度累积机制讲透,让你彻底明白"清梯度"不是仪式,是物理必然。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 46 课
深度学习代码 80% 的报错都是 Shape 不匹配。但 Shape 不只是维度对齐,它是模型每一层之间的数据契约。这篇把 batch、特征、类别维度和常见的 Shape 流水线一次讲透。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 47 课
reshape 和 view 看起来一样,transpose 和 permute 也像兄弟,广播机制报错信息又长又看不懂。这篇用最小代码讲清它们的区别,让你不再瞎试。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 48 课
PyTorch 内置数据集只够入门练手。真实项目里你的数据可能是 CSV、文件夹图片、JSON 文本——这时候必须自己写 Dataset。这篇把 __len__ 和 __getitem__ 讲透,附带三个真实场景。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 49 课
第 17 篇你学了 DataLoader 的基本用法。但 batch_size 调多大、shuffle 为什么必须开、num_workers 设几、drop_last 有什么用——这些细节决定训练是 5 分钟还是 5 小时。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 50 课
所有 PyTorch 模型都继承 nn.Module。但你可能不知道,它帮你做了参数注册、子模块管理、train/eval 切换、设备迁移四件大事。这篇把 nn.Module 的黑盒拆开。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 51 课
把所有权重初始化成 0,模型直接学不动。初始化成太大的随机数,梯度爆炸。初始化是训练的起跑线,起跑线错了后面全白费。这篇讲清为什么初始化重要、常见方法怎么选。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 52 课
梯度下降是所有优化器的祖宗。SGD 是最朴素的实现,Momentum 加了惯性。搞懂这两个,才能理解后面 Adam 在"智能"什么。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 53 课
SGD 给所有参数同一个学习率。但有些参数变化剧烈、有些几乎不动,统一步长不合理。AdaGrad 和 RMSProp 让每个参数有自己的自适应学习率。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 54 课
Adam 把 Momentum 的"方向惯性"和 RMSProp 的"自适应步长"合体,开箱即用。AdamW 修复了 Adam 权重衰减的耦合 bug,成为 Transformer 的标配。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 55 课
学习率是训练里最敏感的超参数——太大 loss 爆炸,太小 loss 不动。这篇讲清怎么判断学习率过大过小,以及 StepLR、CosineAnnealing 等衰减策略怎么选。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 56 课
RuntimeError: Expected all tensors to be on the same device —— 这是你用 GPU 训练时最常遇到的报错。模型在 GPU、数据在 CPU,它们碰不到一起。这篇讲清设备迁移的完整流程。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 57 课
模型训练集准确率 99%,测试集只有 70%——这是过拟合。Weight Decay、Dropout、Early Stopping、数据增强怎么选?这篇建立完整的正则化方法地图。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
 第 58 课
训练 loss 不降?降了又升?训练好测试差?这篇把前面所有训练知识串成一套系统化的诊断流程,让你看曲线就知道问题在哪。
PyTorch 深度学习基础(43~58):独立搭建一个 PyTorch 训练脚本,正确处理 Shape、device、梯度清空、优化器选择和学习率策略,并能根据 loss/accuracy 曲线诊断训练问题。
10 个视频,按学习路线顺序排列。
 第 59 课
前面 14 篇学了原理,现在第一次完整跑一个深度学习项目——从造数据、建模型、训练到预测。用最简单的线性回归,把全流程跑通。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 60 课
线性回归是连续预测,分类是离散判断。这篇从零搭建一个二分类神经网络,用二维数据让你能"看到"模型怎么把两类点分开。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 61 课
准确率 99% 但不知道模型怎么分的?这篇把分类模型的决策边界画出来,让你亲眼看到模型在二维空间画了一条什么形状的分界线。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 62 课
前面用造的数据练手,这次用真实 CSV 表格数据。从读取、预处理、模型搭建到训练评估,走完表格分类的完整流程。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 63 课
训练好的模型不能只活在内存里。这篇讲清怎么把模型存成文件、怎么加载回来预测、怎么做批量推理,以及断点续训的完整做法。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 64 课
图像不能直接用全连接层处理——参数太多、丢失空间结构。CNN 用卷积提取局部特征,用池化压缩尺寸。这篇用最小代码讲清卷积核在做什么。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 65 课
一张普通图片进入 PyTorch 后为什么会变成 [B, C, H, W]?这篇从 PIL、NumPy、Tensor、归一化和 DataLoader 出发,把图像送进 CNN 前的完整数据流讲清楚。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 66 课
从数据增强、CNN、训练循环、验证指标到保存最佳权重,完整跑通一个 PyTorch 图像分类项目,并理解每一段代码为什么存在。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 67 课
准确率只能告诉你错了多少,混淆矩阵和错误样本才能告诉你错在哪里。这篇建立一套从类别指标、混淆矩阵到高置信度错误图的分析流程。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
 第 68 课
把散落在单文件里的 PyTorch 代码整理成可维护项目:配置、数据、模型、训练引擎、日志、检查点和推理各归其位,并保留可复现实验所需信息。
深度学习项目:能独立完成一个完整深度学习项目,从数据到推理全流程,并整理出可复用的项目目录结构。
1 个视频,按学习路线顺序排列。
第 69 课从一句中文出发,理解字符、词与子词的切分,运行 Python 构建词表,再用互动实验观察 Token、编号与未知输入。配套 1080p 中文讲解视频。
NLP 与序列模型(69~78):能把中文文本处理成序列数据,用 FastText、RNN 或 LSTM 完成分类或字符级生成,并解释输入规则和词表的关系。