上一节我们已经知道 CNN 怎样用卷积和池化提取图像特征。但真正训练模型时,第一道门槛往往不是网络结构,而是数据:
- 图片明明是彩色的,为什么 Tensor 的第一维是 3?
- 相册里的图片是
H × W × C,为什么 PyTorch 要求C × H × W? - 单张图片可以推理,训练时为什么又多出一个
B? - 为什么忘记归一化以后,模型可能学得很慢?
这篇把一张图片从磁盘走到 CNN 输入端的全过程拆开。
概念回顾
PyTorch 的二维卷积层 nn.Conv2d 接收四维输入:
[B, C, H, W]| 维度 | 含义 | 例子 |
|---|---|---|
B |
batch size,一次送入多少张图 | 32 |
C |
channel,通道数 | 灰度图 1,RGB 图 3 |
H |
height,图像高度 | 224 |
W |
width,图像宽度 | 224 |
单张 RGB 图片通常是 [3, H, W]。DataLoader 把 32 张同尺寸图片叠在一起后,就得到 [32, 3, H, W]。
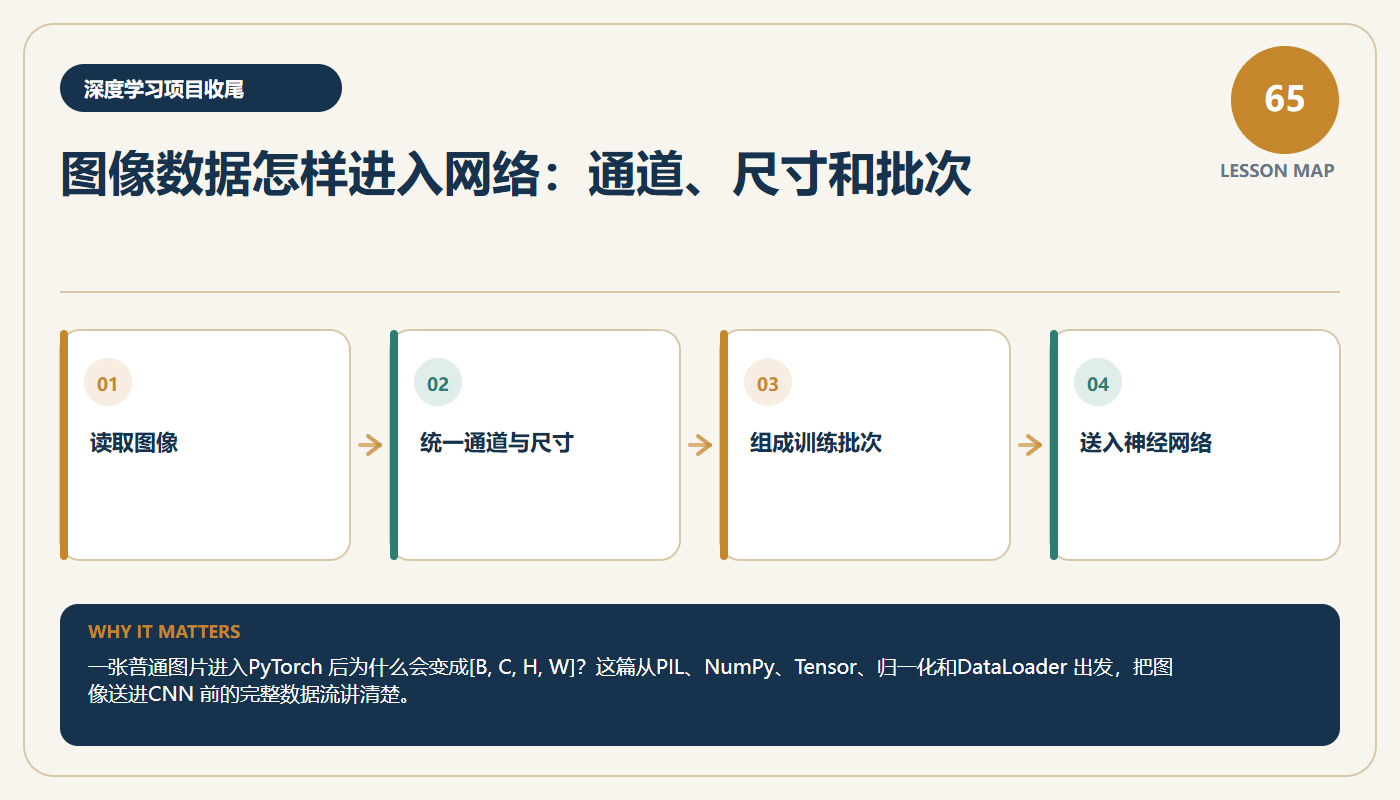
看图抓主线: 读取图像 → 统一通道与尺寸 → 组成训练批次 → 送入神经网络。
看图自测:点击检查自己能否复述这条主线
先遮住上面的正文,只看图回答:
- 这一课的输入是什么?
- 中间最关键的变化发生在哪里?
- 最终输出或判断标准是什么?
- 哪一步最容易出错,为什么?
能用自己的话串起四张卡片,就说明你已经抓住了本课骨架。再回到正文补充公式、代码和边界条件。
一张图片有三种常见表示
同一张图片在程序里可能经过三种表示:
| 表示 | 常见 Shape | 像素范围 | 说明 |
|---|---|---|---|
| PIL Image | (W, H) |
0~255 | 适合读取、裁剪和显示 |
| NumPy 数组 | [H, W, C] |
0~255 | 图像处理库常用 |
| PyTorch Tensor | [C, H, W] |
通常 0~1 | 神经网络常用 |
注意 PIL 的 size 顺序是 (W, H),NumPy 和 PyTorch 的空间维度却通常写成 (H, W)。这是一类很常见的 Shape 错误。
from PIL import Image
import numpy as np
from torchvision.transforms import functional as F

image = Image.open("cat.jpg").convert("RGB")
array = np.array(image)
tensor = F.to_tensor(image)

print("PIL size:", image.size)       # (W, H)
print("NumPy:", array.shape)         # [H, W, 3]
print("Tensor:", tensor.shape)       # [3, H, W]
print("像素范围:", tensor.min().item(), tensor.max().item())  # 0~1
to_tensor 做了两件关键的事:
- 把维度从
[H, W, C]调整成[C, H, W]。 - 把
uint8的 0~255 转成float32的 0~1。
通道到底是什么
RGB 彩色图由红、绿、蓝三张灰度图叠加而成,因此通道数是 3:
RGB 图片 [3, H, W]
├── 第 0 个通道:红色强度
├── 第 1 个通道:绿色强度
└── 第 2 个通道:蓝色强度
灰度图只有明暗信息,所以一般是 [1, H, W],而不是 [H, W]。卷积层需要明确的通道维度。
import torch

gray = torch.randn(28, 28)
gray = gray.unsqueeze(0)       # [28, 28] -> [1, 28, 28]
batch = gray.unsqueeze(0)      # [1, 28, 28] -> [1, 1, 28, 28]
如果模型第一层是:
nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3)那么输入必须是 RGB 三通道;灰度图要么转成 RGB,要么把 in_channels 改为 1。
为什么所有图片要统一尺寸
一个 batch 本质上是多张图片沿第 0 维堆叠:
batch = torch.stack([image1, image2, image3])torch.stack 要求每张图片的 Shape 完全一致。手机照片可能是 4032×3024,网页图片可能是 640×360,所以进入 DataLoader 前通常要统一尺寸。
from torchvision import transforms

train_transform = transforms.Compose([
    transforms.Resize((128, 128)),
    transforms.ToTensor(),
])
直接 Resize((128, 128)) 会强制拉伸。更自然的训练流程常用:
train_transform = transforms.Compose([
    transforms.Resize(144),
    transforms.RandomCrop(128),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
])

val_transform = transforms.Compose([
    transforms.Resize(144),
    transforms.CenterCrop(128),
    transforms.ToTensor(),
])
训练集允许随机裁剪和翻转,制造更多变化;验证集必须稳定,不能每次评估都随机改变。
Normalize 在做什么
ToTensor() 只是把像素缩放到 0~1。Normalize 会继续按通道做标准化:
$$x’ = \frac{x - mean}{std}$$
normalize = transforms.Normalize(
    mean=[0.485, 0.456, 0.406],
    std=[0.229, 0.224, 0.225],
)
完整流程:
train_transform = transforms.Compose([
    transforms.Resize((128, 128)),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    normalize,
])
这里的 mean 和 std 是每个颜色通道各一个。使用预训练模型时,应采用该模型文档要求的归一化参数;从零训练时,可以统计自己的数据集,也可以先用常见值作为基线。
顺序很重要:
Normalize处理的是 Tensor,所以必须放在ToTensor()后面。
用 ImageFolder 组织自己的数据
最简单的图像分类目录结构是:
dataset/
├── train/
│   ├── cat/
│   │   ├── 001.jpg
│   │   └── 002.jpg
│   └── dog/
│       ├── 001.jpg
│       └── 002.jpg
└── val/
    ├── cat/
    └── dog/
文件夹名就是类别名:
from torchvision.datasets import ImageFolder
from torch.utils.data import DataLoader

train_dataset = ImageFolder("dataset/train", transform=train_transform)
val_dataset = ImageFolder("dataset/val", transform=val_transform)

print(train_dataset.classes)          # ['cat', 'dog']
print(train_dataset.class_to_idx)     # {'cat': 0, 'dog': 1}

train_loader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True,
    num_workers=0,
)

images, labels = next(iter(train_loader))
print(images.shape)   # [32, 3, 128, 128]
print(labels.shape)   # [32]
print(labels.dtype)   # torch.int64
在 Windows 上第一次练习建议先把 num_workers 设为 0。流程稳定后再逐步增加,并把启动代码放进:
if __name__ == "__main__":
    ...
不依赖真实图片的 Shape 自检
还没有准备数据集时,可以用 FakeData 先把模型和训练循环跑通:
from torchvision.datasets import FakeData
from torchvision import transforms
from torch.utils.data import DataLoader

dataset = FakeData(
    size=100,
    image_size=(3, 128, 128),
    num_classes=4,
    transform=transforms.ToTensor(),
)

loader = DataLoader(dataset, batch_size=16, shuffle=True)
images, labels = next(iter(loader))

assert images.shape == (16, 3, 128, 128)
assert labels.shape == (16,)
print(images.dtype, labels.dtype)
这是很实用的工程习惯:先证明“数据 Shape → 模型输出 → loss”可以连通,再接入真实数据。
送进模型前的五项检查
images, labels = next(iter(train_loader))

print("images shape:", images.shape)
print("images dtype:", images.dtype)
print("images range:", images.min().item(), images.max().item())
print("labels shape:", labels.shape)
print("labels:", labels[:8])
你至少要确认:
- 图片是四维
[B, C, H, W]。 - 图片类型通常是
torch.float32。 - 标签是
[B],多分类时通常为torch.int64。 C与模型第一层的in_channels一致。- 类别编号位于
0到num_classes - 1。
三个高频错误
错误 1:把 HWC 直接送进 Conv2d
# 错误:[B, H, W, C]
images = torch.randn(32, 128, 128, 3)

# 正确:[B, C, H, W]
images = images.permute(0, 3, 1, 2)
错误 2:训练集和验证集的类别编号不同
如果两个目录缺少不同类别,分别创建 ImageFolder 可能得到不同的 class_to_idx。训练前应打印并确认:
assert train_dataset.class_to_idx == val_dataset.class_to_idx错误 3:归一化后仍按 0~1 显示图片
Normalize 后的 Tensor 可能小于 0 或大于 1。可视化前要反归一化,否则颜色会很奇怪。
课后练习
练习 1:一批 64 张灰度图片,每张 28×28,正确的输入 Shape 是什么?
练习 2:为什么训练集可以使用 RandomCrop,验证集却更适合 CenterCrop?
练习 3:写一个检查函数,输入 images 和 labels,验证它们是否适合 5 分类 CNN。
参考答案 / 自检思路
练习 1:[64, 1, 28, 28]。灰度图也必须保留通道维度。
练习 2:训练集随机增强可以提高泛化能力;验证集用于稳定比较模型,若每次随机裁剪,指标会额外波动。
练习 3:
def check_batch(images, labels, num_classes=5):
    assert images.ndim == 4
    assert images.dtype == torch.float32
    assert labels.ndim == 1
    assert labels.dtype == torch.long
    assert images.size(0) == labels.size(0)
    assert 0 <= labels.min() and labels.max() < num_classes
核心要点小结
- PyTorch 图像输入使用
[B, C, H, W],不是常见图像库的[B, H, W, C]。 ToTensor会调整通道顺序,并把常见的 0~255 像素转换为 0~1 浮点数。- 同一 batch 内的图片尺寸必须一致,因此需要 Resize、Crop 等变换。
- 训练增强可以随机,验证预处理必须稳定。
ImageFolder用文件夹名建立类别编号,训练集与验证集的映射必须一致。- 训练前先检查 Shape、dtype、数值范围和标签范围,能提前消灭大量错误。
下一篇我们会把这些数据真正送进 CNN,完成第一个从训练、验证到保存最佳模型的图像分类项目。
留言讨论