客服工单、内容审核、检索片段筛选,这些任务最后都要落到一个封闭决定:分给谁、过不过、排第几。聊天模型会写一段很像样的理由。程序真正要的,是一个能分支的值和一份能设阈值的概率。
TypeSafe 把 Jev 称为第一款 System One 模型。你交出一段状态和几道封闭问题,它交回选择、分数和是非概率。文档化的响应里没有解释文本。本文按 2026-10-12 能核到的官方文档和独立论文来写。厂商主页上的“193 倍更快、444 倍更便宜”带有任务限定,下面不把它当成普遍测量。
这是一篇独立笔记,不是课程第 70 课。概率条和阈值可以在交互页里拖:
还没建立“概率、阈值、错了怎么办”的直觉,先看准确率、精确率、召回率和 F1。
30 秒定义
Jev 是 TypeSafe 的旗舰模型,也是他们公开的第一款 System One 模型。System One 这个名字借自卡尼曼《思考,快与慢》里的系统 1:快、窄、针对眼前材料做判断。官方强调的是“给软件用的快速判断”,不是声称复现了心理学理论。
调用入口是 POST https://api.typesafe.ai/v1/systemone。一次请求有三块:
| 字段 | 作用 |
|---|---|
state |
要判断的内容。字符串、JSON 对象,或文本数组 |
model |
文档中的稳定别名 jev-latest 当前指向 jev-1.13.0 |
questions |
你命名的问题表。键只用于把答案对回去,不参与推理 |
三种问题可以混在同一次调用里。官方写明:问题彼此隔离,并行对着同一份状态作答,多加问题不会互相污染上下文。
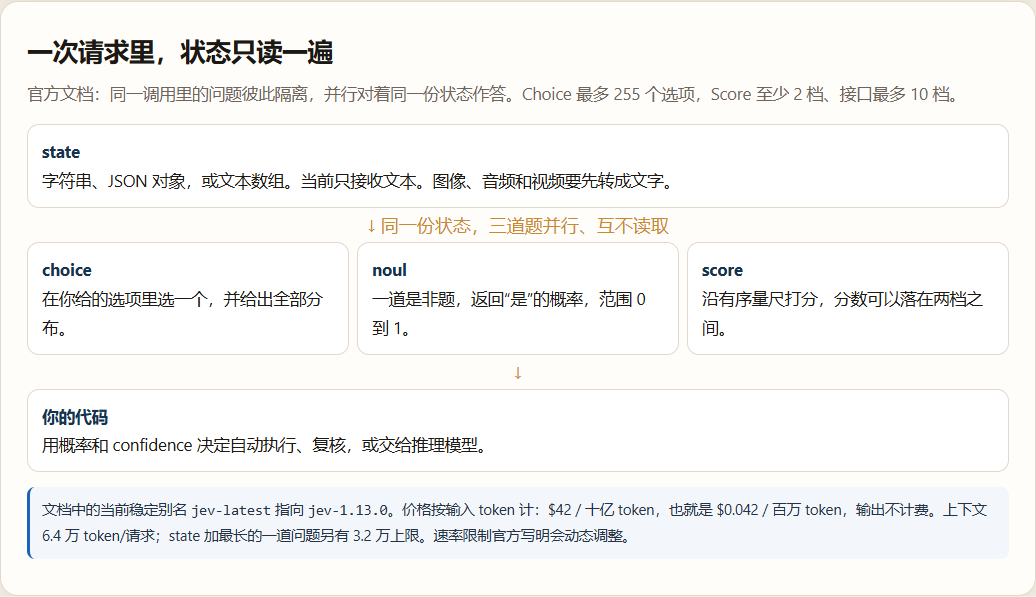
当前模型卡片上的约束,原样记在这里:
- 只收文本。图像、音频、视频要先转成文字。
- 价格按输入 token 计:$42 / 十亿 token,即 $0.042 / 百万 token。输出不计费。
- 上下文 6.4 万 token/请求。
state加上最长的一道问题,另有 3.2 万 token 上限。 - 速率限制写的是 10 万 token/秒、80 请求/秒,并注明会随负载动态调整。
- 不为单个客户微调。领域差异放进
state、instructions和criteria。 - 英语是主要训练语言。中日韩可以处理,但并不均衡。用自己的中文样本测过,再定阈值。
它和聊天模型差在输出合同
点开下面这张图里的三张卡片,看到的是三种不同合同。
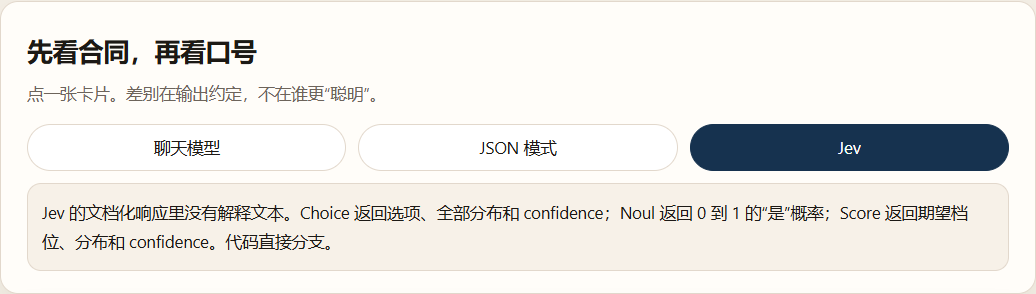
聊天模型按下一个 token 生成给人读的文字。它可以说“我有九成把握”。这句话的生成概率,并不等于这件事有 90% 为真。
JSON 模式仍然在生成 token,只是形状被约束住。解析失败、多出来的字段、一段听起来很确定的解释,都还在生成链上。
Jev 的文档化响应直接给类型化字段:
| 问题 | 你要提供的 | 它交回的 |
|---|---|---|
choice |
最多 255 个选项,每项可附说明 | 最高概率选项、全部分布、confidence |
noul |
一道是非题,可说明“是/否”各指什么 | 0 到 1 的“是”的概率。文档不单列 confidence |
score |
有序量尺,至少 2 档,接口最多 10 档 | 期望档位、每档概率、confidence。分数可以落在两档之间 |
官方对使用方式的建议很具体:一个问题只问一件能在几秒内判断的事。如果一个判断里夹了好几件独立的事,拆开问,权重留在你的代码里。优先级变了,改系数,不必重写提示词。
同一张工单,看代码怎么消费分布
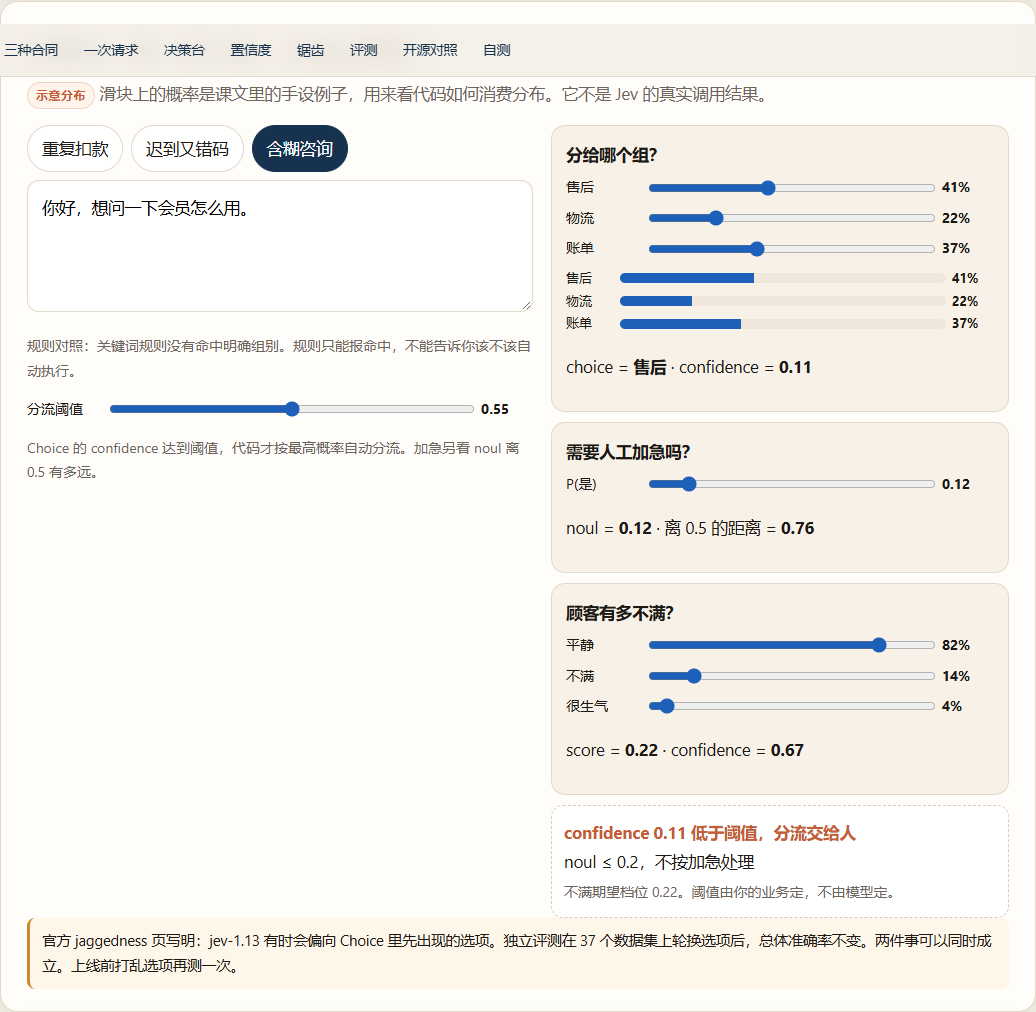
下面两张图里的概率是示意分布,用来演示官方置信度公式和分流策略。它们不是某次 Jev 调用的真实返回。交互页里可以换工单、拖滑块、改阈值:
第一张是“订单被扣了两次,请马上退回”。示意分布把 86% 放在售后。按官方 Choice 公式,confidence 是 0.79。阈值设在 0.55 时,代码可以自动分流。加急概率 0.78,还没到单独设定的 0.80,所以加急仍然留给人看。组别清楚,不等于事情紧急。
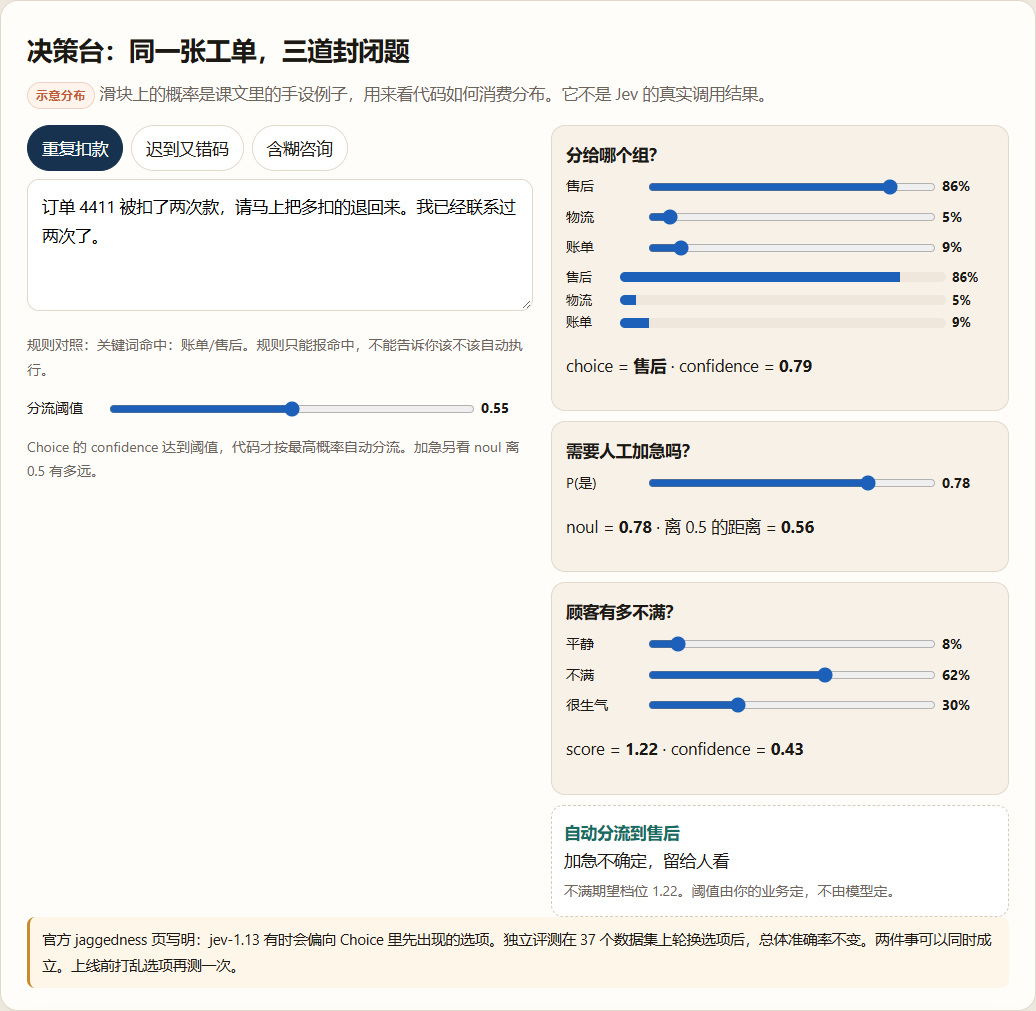
第二张是“想问一下会员怎么用”。三个组的概率挤在一起,confidence 只有 0.11。同一阈值下,分流交给人。关键词规则这时什么也没命中。规则能报命中,不能告诉你该不该自动执行。
请求形状和官方文档一致。下面的 JSON 是接口示例,不是一次真实账单:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": "订单 4411 被扣了两次款,请马上把多扣的退回来。",
    "model": "jev-latest",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "这张工单应该交给哪个组?",
        "criteria": {
          "售后": "退款、换货、错件",
          "物流": "延误、丢件、配送状态",
          "账单": "重复扣款、发票、支付"
        }
      },
      "urgent": {
        "type": "noul",
        "instructions": "这张工单是否表达了明确的时间压力?",
        "criteria": {
          "true": "写出了马上、已经等了很久,或限定了时限",
          "false": "没有时间压力"
        }
      },
      "mood": {
        "type": "score",
        "instructions": "顾客的不满有多强?",
        "criteria": ["平静", "不满", "很生气"]
      }
    }
  }'
响应按问题 id 原样返回。Choice 里会有 choice、probabilities、confidence。Noul 里是一个 noul 数字。Score 里会有 score、legend、probabilities、confidence。usage 只计 token。Python SDK 的导入方式以官方 SDK 文档为准,文档示例使用 typesafe_sdk.TypeSafeClient。
置信度是从分布里算出来的
TypeSafe 把 confidence 定义成分布的一个固定摘要,方便第一次调用就用同一把 0 到 1 的尺子做门控。它不是准确率,也不是模型另写的一句“我很有把握”。完整概率仍在响应里,你可以用最高概率,或最高概率和次高概率之比,替换这把默认尺子。
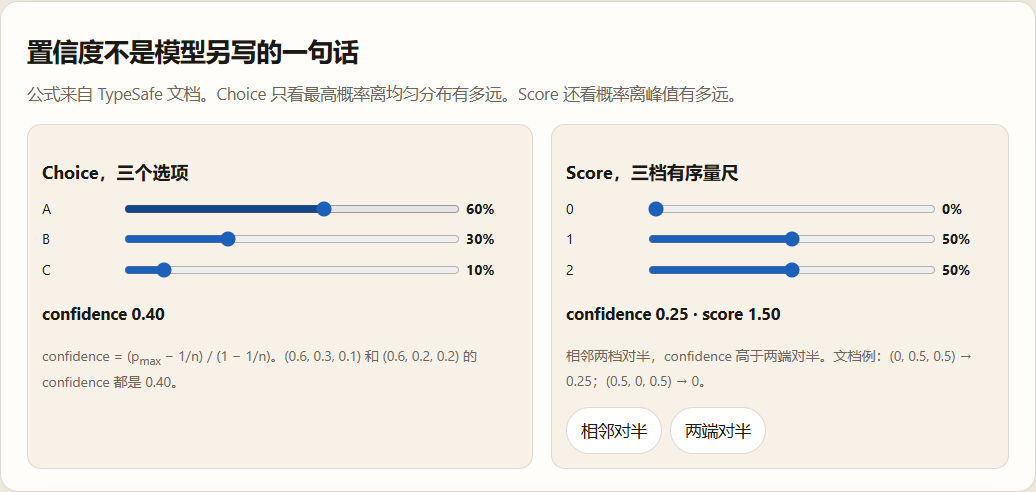
Choice,n 个选项,p_max 是最高概率:
confidence = (p_max - 1/n) / (1 - 1/n)三个选项时,(0.60, 0.30, 0.10) 和 (0.60, 0.20, 0.20) 的 confidence 都是 0.40。公式只看顶峰离均匀分布有多远,不看剩下的质量怎么分。
Noul 不单列 confidence。若要和 Choice 用同一段门控代码,文档给的换算是 |2p - 1|。0.5 时为 0,0 或 1 时为 1。
Score 的档位有顺序,所以还要看概率离峰值有多远。n 档、峰值在 m:
confidence = max(0, 1 - Σ p_i |i - m| / MAD_unif)
MAD_unif = (1/n) Σ |i - (n - 1) / 2|
三档时,(0, 0.5, 0.5) 的 confidence 是 0.25,因为模型在相邻两档之间犹豫。(0.5, 0, 0.5) 是 0,因为犹豫发生在两端。Choice 公式会把这两种分布都算成 0.25。
阈值跟风险走,不跟模型走。只读分类可以松一些,退款和封号要更严。文档的原话是:先用保守阈值,在自己的数据上观察,再调整。一份 37 个数据集的独立评测也印证了这一点:二分类概率的排序有用,但钉死在 0.5 上并不好。UNFAIR-ToS 的 micro-F1 在训练集上调阈值之后,从 0.50 升到 0.75。
想把阈值怎么改变自动执行的比例继续拖一遍,打开交互页。
官方自己列出的锯齿
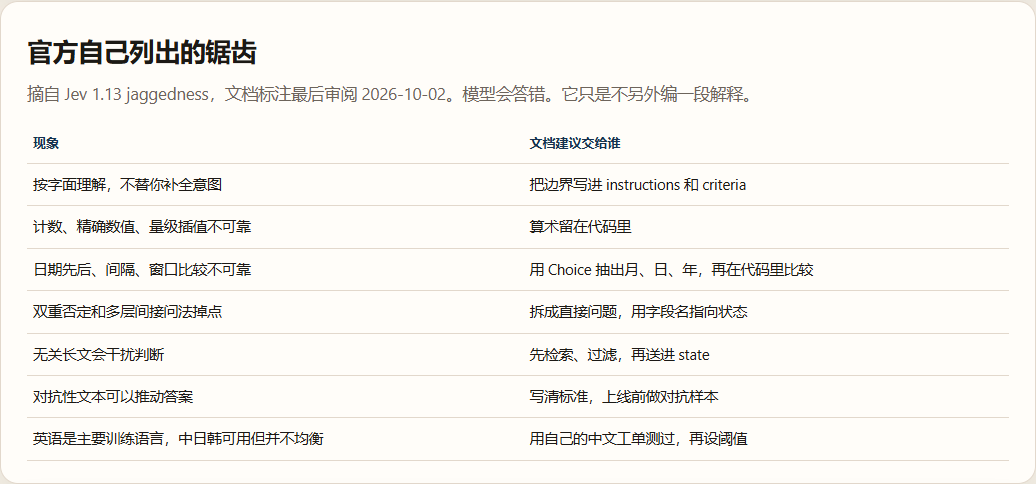
jev-1.13 的 jaggedness 页标注最后审阅于 2026-10-02。它快,也有校准目标,同时会答错。它只是不另外编一段解释。
和中文业务最相关的几条:
- 它回答你写下的条件,不替你补全意图。否定、范围词、隐含前提,都按字面读。觉得它“没懂”,那句解释通常就是漏写的指令。
- 计数、精确数值、用 Score 在两档之间插值去还原一个真实数字,都不可靠。算术留在代码里。
- 日期的先后、间隔、是否落在窗口内,不可靠。抽出月、日、年这些封闭字段,比较交给代码。
- 双重否定和多层间接问法会掉点。直接问,并用字段名指向状态里的那一块。
- 无关长文会干扰判断。先检索、过滤,再送进
state。 - 对抗性文本可以推动答案。写清标准,上线前做对抗样本。
- 选项顺序有时会影响答案,模型会偏向先出现的选项。独立评测在 37 个数据集上轮换选项后,总体准确率不变。两件事可以同时成立。上线前打乱选项再测一次。
- 它不负责生成文本。把 Choice 串起来逼它写句子,又慢又差。需要生成时,换生成模型。
独立评测怎么说
下图右侧的数字都来自论文摘要,没有把没公布的逐数据集分数补进去。
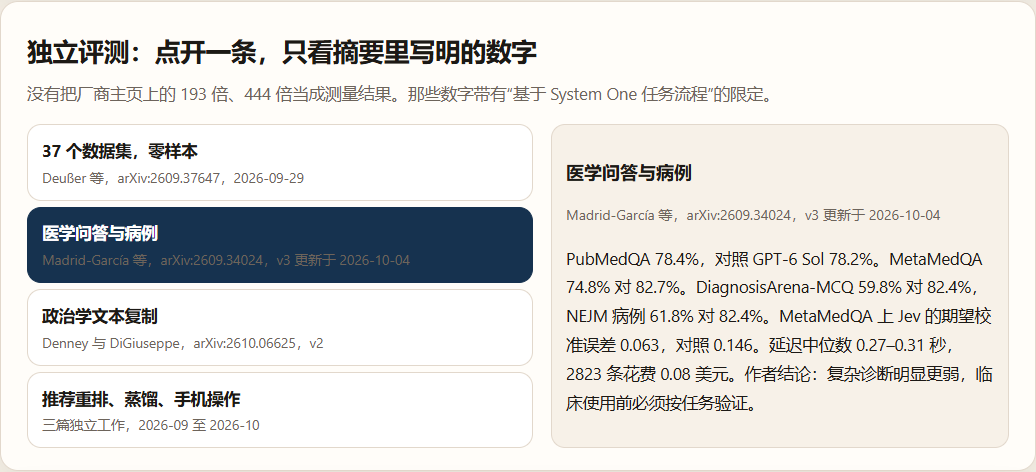
分类与阅读。 Deußer、Sparrenberg、Sifa 在 arXiv:2609.37647 评测了 jev-1.13.0:37 个数据集、34.6 万次请求,费用不到 10 美元。IMDB、SST-2、HellaSwag、ARC 的准确率落在 95%–99%。Belebele 122 种语言 86.7%。37 项里有 27 项高于 Qwen3.8-27B,Qwen 领先的 9 项都没有超出自助法区间;37 项全部高于 Gemma-4-E4B。抽掉问题后接近随机,所以不是只靠背下选项文字。低资源语言、细粒度或噪声标签、量尺式质量判断上,Jev 和两个开源对照都会变差。
医学。 Madrid-García 与 Merino-Barbancho 的 v3(arXiv:2609.34024)里,PubMedQA 上 Jev 78.4%,对照 GPT-6 Sol 78.2%。MetaMedQA 74.8% 对 82.7%。诊断选择题 59.8% 对 82.4%,NEJM 病例 61.8% 对 82.4%。MetaMedQA 上 Jev 的期望校准误差 0.063,对照 0.146。延迟中位数 0.27–0.31 秒,2823 条花费 0.08 美元。作者的结论写得很清楚:摘要题接近前沿模型,复杂诊断明显更弱,临床使用前必须按任务验证。
政治学文本。 Denney 与 DiGiuseppe(arXiv:2610.06625,v2)在七项已发表复制里,看到 Jev 接近或达到对照 LLM 的标注能力。按 OpenAI 批量价,相对 GPT-6 Luna 没有成本优势。单次提问时,Jev 的概率校准好于 GPT-6 Luna 的 token 概率,但不稳定地好于 Qwen3.8-27B。作者认为,若不追求速度,明显优势是选择概率更容易被程序消费。
另外三篇把边界说得更具体。推荐重排里,效果相对所测基线保持得住,延迟随候选规模增长比逐条 Qwen 重排更缓,但仍明显高于推荐专用模型。国际象棋搜索里,在线调用太慢,作者把成对判断蒸馏成小评估器。手机界面操作里,Jev-Mobile 在 AndroidWorld 上的任务成功率是 79%,逐步调用视觉语言模型的基线是 84%;成功轨迹上平均耗时降 32.7%,模型 API 费用降 73.4%。
这些数字支持一个用法:Jev 适合放在流水线里做封闭判断。它不适合替代推理模型去做多层诊断,也不适合替代一个已经很快的专用排序器。
想自己跑,先把 Jev 和 Kev 分开
Jev 是托管模型。官方写明,客户请求不会用来训练它。
Kev 是 Jared Palmer 发布的开源家族,接口对齐 TypeSafe 的 System One,底座是 Qwen3.5 / Qwen3.8。它不是 Jev 的权重。仓库自己写了:不知道 Jev 的训练集,所以两边的分数不是一次受控的架构对比。在其 new-source 开发集上,Kev-27B 准确率 0.851,Jev 0.857。
第三方文章《Jev’s Architecture Unmasked》是用黑盒请求去推测结构。Kev 的指针头是复现者的实现。这两份材料可以用来理解“状态共享、问题隔离、直接读概率”这一类设计,不能写成 TypeSafe 的架构说明书。
官方没有公开权重,也没有发表 Jev 的正式技术报告。训练路径在文档里叫 RLCD,Reinforcement Learning for Calibrated Decisions:优化的是决策和校准后的概率,而不是人更爱读的回复。文档把 RLHF 的共同发明者、TypeSafe 联合创始人 Diogo Almeida 作为这条对照的来源。校准描述的是一批预测:标成 0.8 的那一组,大约应有 80% 为真。它不保证任何一条单独答案正确。
中文业务上线前的检查单
- 每个问题只判断一件事。退款资格、是否重复扣款、策略是否允许,分成三道题,再用代码组合。
- 用至少一两百条自己的中文工单测准确率、校准和“自动执行后的错误率”。英文阅读题的 86.7% 不能直接挪过来。
- 阈值按错误预算来定。先保守,再放宽。
- 打乱 Choice 选项,看答案是否稳定。
- 计数、金额、日期比较留在代码里。模型只做封闭字段上的判断。
- 送进
state之前先去掉与问题无关的长文。 - 需要写回复、写代码、做多层诊断时,换生成模型或推理模型。Jev 放在它们前面做路由和复核。
官方食谱里已经有对应的拼法:按置信度分流、把一个大判断拆成几个原子分、给生成模型的输入输出做护栏、核对引用是否被原文支持、给检索片段打分。这些都是代码掌舵,模型只做窄判断。
和课程主线的关系
课程仍按“先原理、再代码、再项目”往下走。下一课还是词表和编号,不把这篇插进课程序列。
参考资料
核对日期:2026-10-12。
- TypeSafe 文档:Introduction、System One、Models、Confidence、Jev 1.13 jaggedness、API、AI primer
- Deußer, Sparrenberg, Sifa. Evaluating and Benchmarking the System One Model Jev. arXiv:2609.37647, 2026-09-29. 代码:https://github.com/AppliedMachineLearning-Lab/jev-benchmarking
- Madrid-García, Merino-Barbancho. Jev in Medicine. arXiv:2609.34024v3
- Denney, DiGiuseppe. JEV versus LLMs. arXiv:2610.06625v2
- Lyu, Xia. Decision-Oriented Recommendation Reranking. arXiv:2609.40241
- Sadoun, Sharif, Banad. From Probabilities to Decisions. arXiv:2610.09188
- Zhang. Jev-Mobile. arXiv:2609.30186
- Kev 仓库与其公开评测表:https://github.com/jaredpalmer/kev
- Hume. Jev’s Architecture Unmasked. 2026-09-17. 黑盒推测,不是官方架构文档
留言讨论